
PDF เป็น Word ภาษาไทย: อะไรเพี้ยนและทำไม
แปลง PDF เป็น Word แล้วภาษาไทยเพี้ยน สระลอย ตารางเบี้ยว หรือไฟล์สแกนอ่านออกมาผิดหมด คุณคิดว่าตัวแปลงไม่ดี ลองอีกตัวก็ได้ผลใกล้เคียงกัน บทความนี้อธิบายว่าอะไรรอด อะไรหาย และทำไมปัญหาบางอย่างไม่หายไปด้วยการเปลี่ยนโปรแกรม

เข้าใจว่าทำไม แล้วคุณจะรู้ว่าควรเลือกเครื่องมือไหนและคาดหวังได้แค่ไหน
PDF คือสิ่งพิมพ์ ไม่ใช่เอกสาร
สิ่งที่อยู่ในไฟล์ PDF คือรายการคำสั่งยาว ๆ ที่บอกว่าให้พิมพ์อักขระตัวนี้ที่ตำแหน่ง 72, 680 ไม่มีที่ใดในไฟล์บันทึกว่าย่อหน้าจบตรงไหน หรือสองบรรทัดไหนเคยอยู่ในแถวเดียวกันของตาราง
ข้อมูลนั้นถูกทิ้งไปตั้งแต่ตอนที่เอกสารถูกส่งออกเป็น PDF เหมือนกระดาษที่พิมพ์ออกมาแล้วไม่ต้องการมันอีก การย้อนกลับจึงเป็นการประกอบขึ้นใหม่ ไม่ใช่การแปลง รูปร่างเดิมถูกอนุมานจากตำแหน่งที่ตัวอักษรวางอยู่
ประโยคเดียวนี้อธิบายที่เหลือทั้งหมด ตารางเบี้ยวไม่ใช่เพราะตัวแปลงอ่านตารางผิด แต่เพราะไม่มีตารางให้อ่านตั้งแต่แรก และต้องอนุมานขึ้นมาจากตำแหน่งล้วน ๆ
สิ่งที่อนุมานได้ กับสิ่งที่ไม่เคยมี
แยกสองอย่างนี้ออกจากกัน แล้วจะรู้ว่าอะไรพัฒนาได้และอะไรทำไม่ได้
- อนุมานได้ การแบ่งย่อหน้า จากระยะห่างบรรทัดและจุดที่บรรทัดหยุด ตาราง จากการที่ช่องเรียงตรงกันลงมาหรือไม่ หัวข้อ จากตัวอักษรที่ใหญ่กว่าเนื้อความ อัลกอริทึมที่ดีขึ้นทำให้แม่นขึ้น
- ดึงออกมาได้ตรง ๆ ตัวอักษรเอง และรูปภาพหรือตราประทับที่พิมพ์อยู่บนหน้า สิ่งเหล่านี้เป็นวัตถุจริงในไฟล์ จึงไม่ต้องเดา
- ไม่เคยถูกบันทึก ต้นฉบับใช้สไตล์ไหนของ Word ตารางผสานช่องตรงไหน ระหว่างย่อหน้าเว้นกี่พอยต์ ไม่มีเครื่องมือใดสร้างสิ่งเหล่านี้ขึ้นมาได้
ระวังตัวแปลงที่ลอกการจัดวางมาทั้งดุ้น
บางเครื่องมือโฆษณาว่าผลลัพธ์ตรงกับต้นฉบับทุกพิกเซล เปิดดูก็ตรงจริง ๆ แล้วพอคุณแก้บรรทัดเดียว เอกสารก็พัง
การทำแบบนั้นหมายถึงยัดข้อความลงในกล่องข้อความหลายร้อยกล่องที่ตรึงไว้ที่พิกัดตายตัว แทนที่จะใส่ในย่อหน้า เอกสารที่สร้างแบบนี้ดูเหมือนต้นฉบับแต่ทำงานต่อไม่ได้ ลบอักขระหนึ่งตัว มีแต่กล่องนั้นที่ขยับ ส่วนรอบ ๆ อยู่นิ่งสนิท
| คุณต้องการอะไร | ควรเลือกอะไร |
|---|---|
| อ่านและแก้ไขเนื้อหา | ตัวแปลงที่ประกอบย่อหน้าขึ้นใหม่ |
| แค่อ่านอย่างเดียว | อย่าแปลง ใช้โปรแกรมอ่าน PDF |
| ต้องเหมือนสิ่งพิมพ์เป๊ะ | อย่าแปลง เก็บเป็น PDF ไว้ |
| ต้องคำนวณตัวเลข | แปลงเป็นสเปรดชีต |
การแปลงมีอยู่เพื่อให้คุณแก้ไขได้ ผลลัพธ์ที่แก้ไม่ได้ก็เสียความหมายไป ถ้าเป้าหมายคือให้ดูเหมือนกันเป๊ะ ตั้งแต่แรกก็ไม่มีเหตุผลที่ต้องแปลง
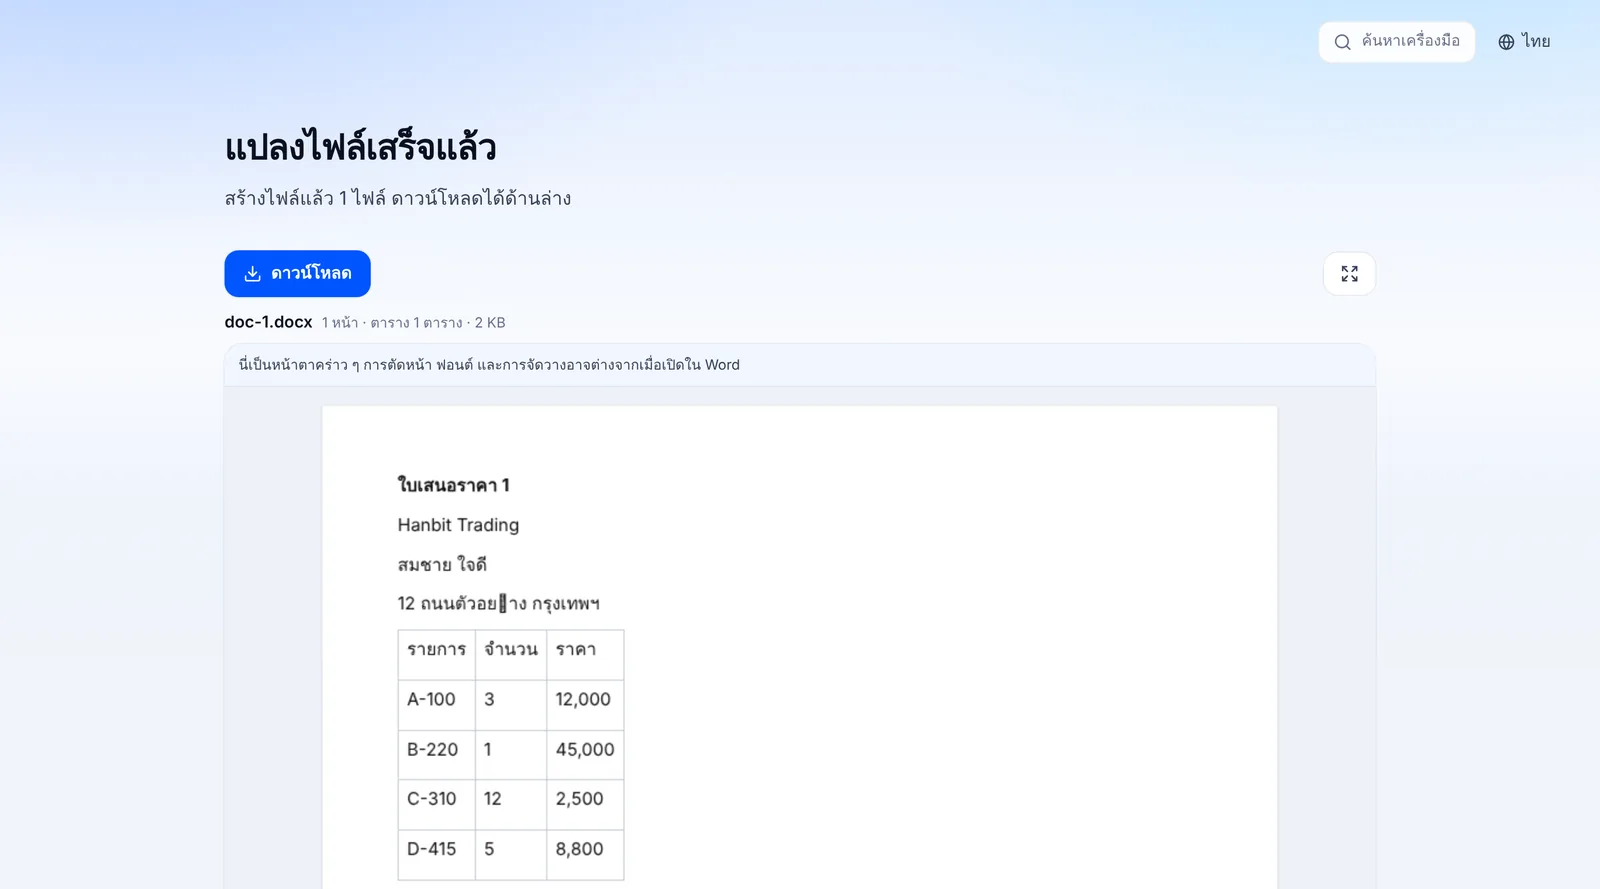
ภาษาไทยหลังแปลง: สระและวรรณยุกต์ที่ต้องตรวจ
ภาษาไทยมีความยากเพิ่มอีกชั้น สระบน สระล่าง และวรรณยุกต์ถูกวาดซ้อนเหนือหรือใต้พยัญชนะ ในไฟล์ PDF เครื่องหมายเหล่านี้อาจถูกเก็บเป็นชิ้นแยก หรือถูกเก็บเป็นรูปตัวอักษรที่จัดตำแหน่งไว้แล้วสำหรับการแสดงผล เมื่อดึงกลับมาเป็นข้อความ บางตัวจึงเปลี่ยนรูปหรือเรียงผิดลำดับ
จากการทดสอบเครื่องมือ PDF เป็น Word ของเรากับเอกสารภาษาไทย ข้อความส่วนใหญ่ออกมาถูกต้อง แต่สระและวรรณยุกต์บางตัวอาจผิด ตัวอย่างที่เจอคือคำว่า น้ำ กลายเป็น นํา ซึ่งบนจอดูคล้ายกันมากแต่เป็นคนละตัวอักษร ค้นหาคำในเอกสารจะไม่เจอ และสะกดผิดเมื่อพิมพ์
หลังแปลงเสร็จ ให้ตรวจข้อความภาษาไทยทุกครั้ง โดยเฉพาะคำที่มีสระอำ วรรณยุกต์ซ้อนสระบน ชื่อคน และตัวเลขสำคัญ ลองใช้คำสั่งค้นหาใน Word หาคำที่ใช้บ่อยในเอกสาร ถ้าค้นไม่เจอทั้งที่เห็นอยู่ แปลว่าตัวอักษรข้างในไม่ตรง
อีกกรณีที่หลายคนเจอในเว็บบอร์ดคือแปลงแล้วภาษาไทยกลายเป็นตัวอักษรขยะทั้งหน้า สาเหตุมักอยู่ที่ฟอนต์ใน PDF ไม่ได้เก็บข้อมูลจับคู่ระหว่างรูปตัวอักษรกับรหัสตัวอักษร ตัวแปลงทุกตัวจึงได้ผลขยะเหมือนกัน เปลี่ยนโปรแกรมก็ไม่ช่วย ต้องขอไฟล์ Word ต้นฉบับจากผู้ส่ง
ปัญหาเดียวกันนี้กระทบการดึงตารางเข้า Excel ด้วย ดูบทความแปลง PDF เป็น Excel ไม่เพี้ยน และถ้าแค่ต้องแก้คำไม่กี่คำ การแก้ใน PDF ตรง ๆ อาจง่ายกว่า ดูบทความแก้ข้อความใน PDF ภาษาไทย
เหตุผลที่แท้จริงที่ตารางออกมาผิด
ตารางใน PDF บ่อยครั้งไม่มีเส้นล้อมรอบเลย ที่มีเส้นก็ถูกวาดอยู่คนละชั้นกับข้อความ มองไม่เห็นจากฝั่งที่ดึงคำออกมา นี่คือเหตุผลที่วิธีซึ่งอาศัยการหาเส้นล้มเหลวบ่อยเหลือเกิน
สิ่งที่ถูกอ่านจึงเป็นตำแหน่ง ช่องที่ขอบซ้ายยืนตรงที่เดียวกันหลายบรรทัดจะถือเป็นตาราง วิธีนี้อ่อนที่สุดเมื่อเจอเซลล์ว่าง เซลล์ว่างไม่ทิ้งร่องรอยในไฟล์ แถวนั้นจึงดูเหมือนมีช่องน้อยไปหนึ่ง และทุกอย่างหลังจากนั้นเลื่อนไปหนึ่งช่อง
เซลล์ที่ผสานกันก็เช่นกัน ตาคุณเห็นสองช่องรวมเป็นหนึ่ง แต่ในไฟล์มีแค่ข้อความชิ้นหนึ่งที่วางเยื้องไปทางซ้ายกว่าเพื่อนบ้านเล็กน้อย
ไม่มีเครื่องมือใดแปลง PDF ที่สแกนมาได้
PDF ที่ได้จากเครื่องสแกนสำนักงานคือภาพถ่ายหนึ่งภาพต่อหนึ่งหน้า ตาคุณเห็นตัวหนังสือ แต่ไฟล์ไม่มีเลย นี่ไม่ใช่ข้อจำกัดของเครื่องมือ แต่เป็นสิ่งที่ขาดหายในต้นฉบับ
การรู้จำอักขระ (OCR) สร้างข้อความขึ้นมาจากภาพได้ แต่นั่นคือการรู้จำ ไม่ใช่การดึงออกมา และมันปนความผิดพลาดแบบอ่านเลขศูนย์เป็นตัว O ภาษาไทยยิ่งยาก มีคนเล่าว่าทำ OCR กับ PDF ภาษาไทยที่สแกนมาแล้วได้ตัวอักษรขยะ เพราะสระและวรรณยุกต์ซ้อนกันจนโปรแกรมแยกไม่ออก ในสัญญาหรือเอกสารที่ต้องยื่น ความผิดพลาดแบบนั้นมีราคาแพง ขอไฟล์ต้นฉบับจากผู้ออกเอกสารมักเร็วกว่า
เครื่องมือ PDF เป็น Word ของเราไม่มี OCR ถ้าหน้าไหนเป็นภาพสแกน มันจะบอกตรง ๆ ว่าหน้านั้นว่าง แทนที่จะส่งไฟล์เปล่ามาให้
สรุปแล้ว
คำถามที่ควรถามเครื่องมือแปลงไม่ใช่ว่าเหมือนแค่ไหน แต่คือคุณแก้สิ่งที่ได้ออกมาได้หรือไม่ และเมื่อผลลัพธ์ไม่สมบูรณ์ การแยกออกว่านี่คือข้อจำกัดของเครื่องมือหรือของรูปแบบไฟล์ จะช่วยให้คุณไม่ต้องเสียเวลาเปลี่ยนเครื่องมือไปเรื่อย ๆ
คำถามที่พบบ่อย
- แปลงแล้วภาษาไทยเพี้ยน ทำไง
- ถ้าเพี้ยนเป็นบางคำ เช่น น้ำ กลายเป็น นํา ให้ค้นหาและแทนที่ใน Word แล้วอ่านทวนทั้งเอกสาร ถ้าเป็นตัวอักษรขยะทั้งหน้า แปลว่าฟอนต์ใน PDF ไม่มีข้อมูลรหัสตัวอักษร เปลี่ยนโปรแกรมก็ไม่ช่วย ต้องขอไฟล์ต้นฉบับ
- แปลงไฟล์สแกนได้ไหม
- เครื่องมือของเราไม่ได้ เพราะไม่มี OCR ไฟล์สแกนไม่มีตัวอักษรอยู่ข้างใน เครื่องมือจะแจ้งว่าหน้าไหนว่าง ถ้าใช้โปรแกรม OCR ที่อื่น ให้ตรวจภาษาไทยทุกบรรทัด เพราะสระและวรรณยุกต์มักอ่านผิด
- ตารางผิดตลอด พอมีทางไหมครับ
- ตารางที่มีเซลล์ว่างมากยิ่งแย่ เพราะเซลล์ว่างไม่ทิ้งร่องรอยใน PDF ถ้าคุณต้องการแค่ตาราง การแปลงเป็นสเปรดชีตดีกว่าแปลงเป็น Word เพราะเส้นทางสเปรดชีตจงใจจับเซลล์ให้เข้าคอลัมน์ และถ้าเบี้ยวก็แก้ด้วยมือได้ง่ายกว่า
- รูปภาพกับตราประทับตามมาด้วยไหม
- ตามมา มันเป็นวัตถุจริงที่พิมพ์อยู่บนหน้า จึงไม่ต้องเดา ดึงออกมาได้ตามที่เป็น ตำแหน่งที่ไปตกจะเรียงตามลำดับการอ่าน ไม่ใช่พิกัดเดิม เพราะการตรึงไว้ที่พิกัดจะได้เอกสารที่แก้ไขไม่ได้
- แบบอักษรเปลี่ยนไป
- PDF ฝังไฟล์แบบอักษรไว้จริง แต่ไม่มีอะไรรับประกันว่ามันมีชื่อตรงกับที่เอกสารต้นฉบับกำหนด และยิ่งไม่มีอะไรรับประกันว่าเครื่องที่เปิดผลลัพธ์จะติดตั้งแบบอักษรเดียวกัน จึงปล่อยแบบอักษรไว้และใช้ค่าเริ่มต้นแทน
- มีตัวแปลงที่ไม่อัปโหลดไฟล์ไหม
- มี เครื่องมือบนเว็บนี้ทำแบบนั้น การแปลงทั้งหมดจบในเบราว์เซอร์ จึงไม่มีขั้นตอนอัปโหลด ถ้าจะตรวจสอบ ให้เปิดแท็บเน็ตเวิร์กในเครื่องมือนักพัฒนาแล้วสั่งแปลง
อัปเดต 14 ตุลาคม 2569 · ข้อมูล ณ เดือนตุลาคม 2026 ผลการแปลงภาษาไทยทดสอบเมื่อวันที่ 14 ตุลาคม 2026


