
Что уцелеет при переводе PDF в Word
Вы переводите PDF в Word, и таблица выходит кривой, шрифты поехали, а строки рассыпались. Вы решаете, что конвертер плохой, пробуете другой и получаете примерно то же. Некоторые задачи не решаются сменой инструмента, а у скана есть своя история: ему нужно распознавание текста.

Понимание причины подсказывает, какой инструмент выбрать и чего от него ждать.
PDF: это отпечаток, а не документ
Внутри PDF лежит длинный список команд вида напечатай этот знак в точке 72, 680. Нигде в файле не записано, где заканчивался абзац и какие две строки принадлежали одной строке таблицы.
Эти сведения выбрасываются в момент экспорта документа в PDF, ровно так же как отпечатанному листу они не нужны. Поэтому вернуть его обратно означает восстановить, а не преобразовать: исходная форма выводится из того, где стоят символы.
Одна эта фраза объясняет всё остальное. Таблица выходит кривой не потому, что конвертер неверно её прочитал, а потому, что читать было нечего и таблицу пришлось вывести из одного лишь расположения.
Что выводится и чего никогда не было
Разделив эти два случая, вы поймёте, что может улучшиться, а что нет.
- Выводится. Границы абзацев: по межстрочным промежуткам и по тому, где строка обрывается. Таблицы: по тому, выравниваются ли ячейки вниз по странице. Заголовки: по кеглю крупнее основного текста. Чем лучше алгоритм, тем точнее результат.
- Извлекается напрямую. Сами символы, а также любые изображения и печати, отпечатанные на странице. Это настоящие объекты в файле, и гадать о них не нужно.
- Никогда не записывалось. Каким стилем Word пользовался оригинал, где в таблице были объединены ячейки, сколько пунктов отбивки стояло между абзацами. Ни один инструмент это не создаст.
Остерегайтесь конвертеров, точно повторяющих вёрстку
Некоторые инструменты обещают результат, совпадающий с оригиналом до пикселя. Открываешь, и правда совпадает. Потом правишь одну строку, и документ рассыпается.
Добиться этого можно, только рассыпав текст по сотням надписей, прибитых к фиксированным координатам, вместо абзацев. Собранный так документ выглядит как оригинал, но работать в нём нельзя. Удалите символ, и подстроится лишь та самая надпись, а всё вокруг останется на месте.
| Что вам нужно | Что выбрать |
|---|---|
| Прочитать и править содержимое | Конвертер, восстанавливающий абзацы |
| Только прочитать | Не преобразовывать, открыть в просмотрщике PDF |
| Точно как в отпечатке | Не преобразовывать, оставить PDF |
| Считать по числам | Преобразовать в таблицу |
Преобразование существует ради того, чтобы вы могли править. Результат, который нельзя править, теряет смысл. Если цель в том, чтобы выглядеть одинаково, то преобразовывать изначально незачем.
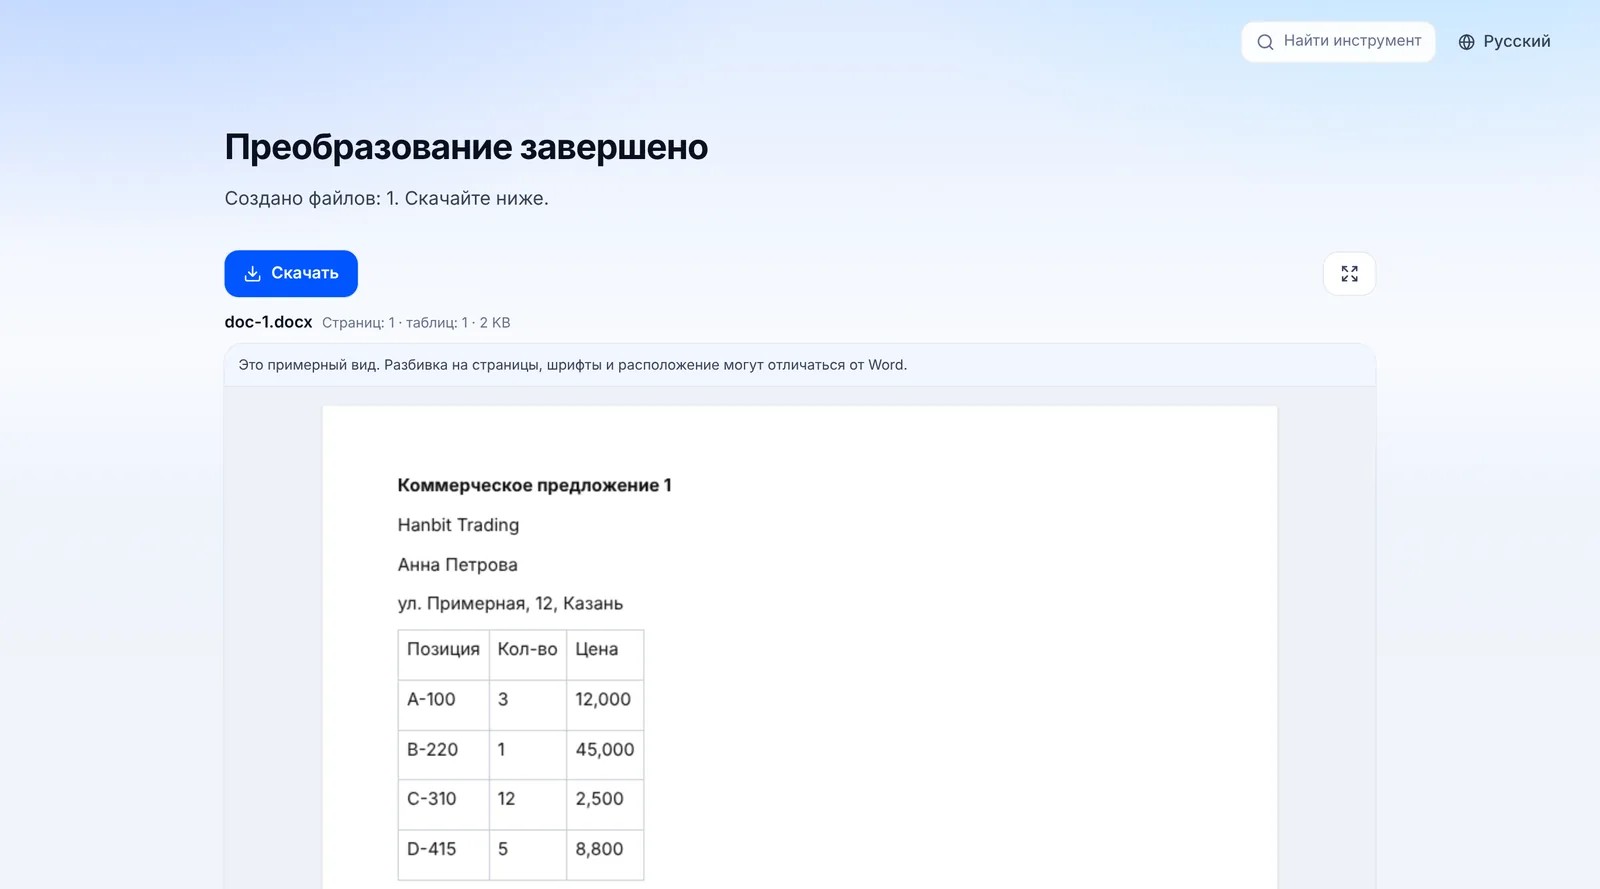
Настоящая причина кривых таблиц
У таблиц в PDF очень часто вовсе нет линий. Там, где они есть, эти линии нарисованы на другом слое, нежели текст, и невидимы для всего, что извлекает слова. Именно поэтому подходы, построенные на поиске линий, так часто дают сбой.
Читается, стало быть, положение: ячейки, левый край которых совпадает на нескольких строках, считаются таблицей. Слабее всего этот метод на пустых ячейках. Пустая ячейка не оставляет в файле следа, поэтому в той строке словно на одну ячейку меньше, и всё последующее сдвигается на одну позицию.
С объединёнными ячейками то же самое. Глаз видит две слитые ячейки, а в файле лежит один кусок текста, стоящий чуть левее соседей.
Скан без распознавания текста
PDF, сделанный офисным сканером или телефоном, состоит из фотографий, по одной на страницу. Глаз видит буквы, файл не содержит ни одной. Это не ограничение инструмента, а отсутствие данных в источнике.
Оптическое распознавание может изготовить текст из картинки. Но это распознавание, а не извлечение, и оно подмешивает ошибки вроде прочтения нуля как буквы O. В договоре или подаваемой форме такая ошибка обходится дорого. Попросить оригинал у того, кто выдал документ, обычно быстрее.
Скажем прямо и про наш инструмент: «PDF в Word» на этом сайте не распознаёт текст на изображениях. Если PDF целиком состоит из сканов, он сообщит, что не может прочитать текст с картинок, а не выдаст пустой документ. Работает он с PDF, в которых есть настоящий текст: выгруженными из Word, бухгалтерских программ, сайтов.
Как отличить одно от другого за секунду: попробуйте выделить слово мышью в программе просмотра PDF. Выделяется, значит текст есть, и перевод в Word сработает. Не выделяется или выделяется вся страница прямоугольником, значит это скан, и сначала понадобится программа с распознаванием текста (OCR). После распознавания обязательно вычитайте цифры, суммы и фамилии.
Перевести PDF с текстом в Word
Если из документа нужна только таблица с числами, лучше переводить её сразу в Excel. Как это сделать без сдвига колонок и с российским форматом чисел, разобрано в отдельной статье.
Коротко говоря
Вопрос к конвертеру не в том, насколько похоже, а в том, можно ли править то, что вышло. И когда результат неидеален, умение отличить предел инструмента от предела формата избавляет от бессмысленной смены инструментов.
Частые вопросы
- Почему PDF в Word съезжает?
- Потому что в PDF нет абзацев и таблиц, есть только координаты символов. Конвертер восстанавливает структуру по расположению, и где расположение неоднозначно (пустые ячейки, объединённые ячейки, колонки), результат съезжает. Сменой конвертера это обычно не лечится.
- Как перевести скан в Word?
- Скану сначала нужно распознавание текста (OCR) в программе, которая это умеет. Наш инструмент «PDF в Word» OCR не делает и работает только с PDF, где есть настоящий текст. После распознавания сверьте цифры и фамилии с оригиналом, если документ важный, или попросите исходный файл у того, кто его выдал.
- Таблицы постоянно выходят неверно. Можно что-то сделать?
- Чем больше в таблице пустых ячеек, тем хуже результат, потому что пустая ячейка не оставляет в PDF следа. Если нужна только таблица, преобразование в электронную таблицу лучше, чем в Word. Там ячейки намеренно раскладываются по столбцам, и поправить смещение руками проще.
- Шрифты поменялись.
- PDF действительно встраивает файлы шрифтов, но нет гарантии, что они несут имя, указанное исходным документом, и тем более что тот же шрифт установлен на машине, где открывают результат. Поэтому шрифты не переносятся и используется стандартный.
- Есть конвертер, который не загружает мой файл?
- Да, инструменты этого сайта работают так. Всё преобразование заканчивается внутри браузера, поэтому шага отправки нет. Чтобы проверить, откройте вкладку сети в инструментах разработчика и запустите преобразование.
Обновлено 14 октября 2026 г. · По состоянию на октябрь 2026 года.


