وقتی PDF به فایل Word تبدیل میشود چه چیزی باقی میماند
یک PDF فارسی را به ورد تبدیل میکنید و کلمهها برعکس شدهاند، حروف از هم جدا افتادهاند یا جدول کج درآمده. گمان میکنید مبدل بد است، یکی دیگر را امتحان میکنید و تقریباً همان نتیجه را میگیرید. بعضی مشکلها با عوض کردن ابزار برطرف نمیشوند؛ اینجا میگوییم چه چیزی سالم میماند، چرا فارسی سختتر است و پیش از فرستادن فایل چه چیزی را چک کنید.

دانستن دلیلش به شما میگوید کدام ابزار را انتخاب کنید و چقدر از آن انتظار داشته باشید.
PDF یک چاپ است، نه یک سند
آنچه درون یک PDF نشسته فهرست بلندی از دستورهاست که میگوید این نویسه را در ۷۲ و ۶۸۰ چاپ کن. هیچجای فایل ثبت نشده که بند کجا تمام شده، یا کدام دو سطر به یک ردیف از یک جدول تعلق داشتهاند.
این اطلاعات درست همان لحظهای دور ریخته میشود که سند به PDF صادر میشود، همانطور که یک برگ چاپشده به آن نیازی ندارد. پس برگرداندنش بازسازی است نه تبدیل: شکل اصلی از جای نشستن نویسهها استنتاج میشود.
همین یک جمله بقیه را توضیح میدهد. جدول کج درمیآید نه چون مبدل آن را اشتباه خوانده، بلکه چون اصلاً جدولی برای خواندن نبوده و باید تنها از روی موقعیت استنتاج میشده است.
آنچه استنتاج میشود و آنچه هرگز نبوده
جدا کردن این دو به شما میگوید چه چیزی میتواند بهتر شود و چه چیزی نه.
- استنتاجشدنی. جدا شدن بندها، از فاصله سطرها و از جایی که سطر میایستد. جدولها، از اینکه خانهها رو به پایین همتراز میمانند یا نه. عنوانها، از قلمی بزرگتر از متن اصلی. الگوریتم بهتر دقت را بالا میبرد.
- مستقیم بیرونکشیدنی. خود نویسهها، و هر تصویر یا مهری که روی صفحه چاپ شده است. اینها اشیای واقعی درون فایلاند و حدسی در کارشان نیست.
- هرگز ثبتنشده. اینکه نسخه اصلی از کدام سبک Word استفاده کرده، جدول کجا خانه ادغامشده داشته، میان بندها چند پونت فاصله بوده. هیچ ابزاری نمیتواند اینها را بسازد.
فارسی: کلمههای برعکس، حروف جدا، ی و ک عربی
اگر این را میخوانید، احتمالاً همین مشکل را دارید و تنها نیستید: در انجمن P30World کاربری نوشته بود بعد از تبدیل PDF به ورد کلمهها و جملهها بههم ریختهاند، و در انجمن Soft98 رشتهٔ بلندی سالها دربارهٔ «تبدیل PDF فارسی به ورد بدون مشکل» ادامه داشته، با یک رشتهٔ جدا فقط برای ترفندهای این کار.
دلیلش در همان «PDF یک چاپ است» نهفته است، با دو لایهٔ اضافه برای فارسی:
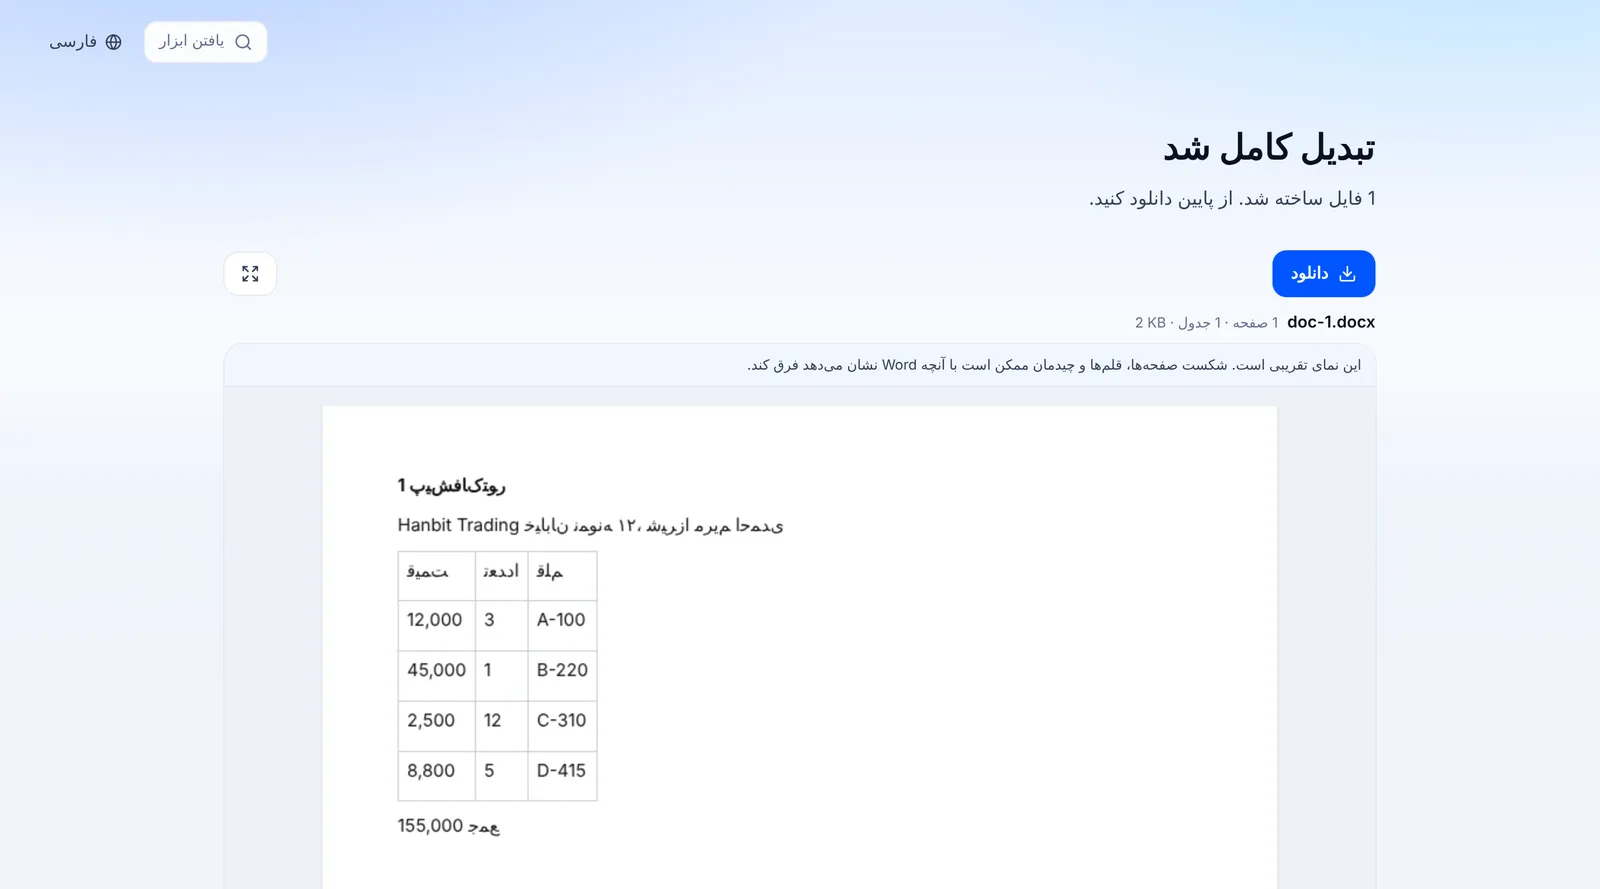
- ترتیب: PDF حروف را به ترتیبی ذخیره میکند که روی صفحه کشیده میشوند، و این لزوماً ترتیب خواندن راستبهچپ نیست. مبدل باید ترتیب منطقی را حدس بزند. هر جا عدد یا کلمهٔ انگلیسی وسط جملهٔ فارسی باشد، این حدس سختتر میشود و جای کلمهها جابهجا میشود یا کل کلمه برعکس بیرون میآید.
- شکل حروف: هر حرف فارسی بسته به جایش چند شکل دارد. بعضی PDFها بهجای خود حرف، «شکل نمایشی» آن را ذخیره میکنند. مبدلی که این شکلها را به حرف اصلی برنگرداند، متنی تحویل میدهد که روی صفحه شبیه فارسی است ولی حروفش جدا از هماند، جستوجو نمیشود و با تایپ جدید جور درنمیآید.
- ی و ک: سندهایی که با نرمافزار یا صفحهکلید عربی ساخته شدهاند، ي و ك عربی دارند. در ورد درست دیده میشوند، اما جستوجو، مرتبسازی و غلطیاب روی آنها کار نمیکند.
- نیمفاصله: فاصلهٔ مجازی در «میشود» و «فایلها» اغلب در PDF ثبت نمیشود یا به فاصلهٔ کامل تبدیل میشود.
دربارهٔ ابزار خودمان صریح بگوییم: PDF به Word ما را با PDF فارسی آزمودیم و درست کار نمیکند؛ حروف برعکس یا شکسته بیرون میآیند. فعلاً آن را برای سندهای فارسی مناسب ندانید. برای PDF انگلیسی و جدولهای عددی خوب کار میکند.
بعد از تبدیل، چه چیزی را چک کنید
- یک پاراگراف را با اصل مقایسه کنید: ترتیب کلمهها، جای عددها و پرانتزها.
- یک کلمه را جستوجو کنید. اگر پیدا نشد، احتمالاً حروف جدا یا عربیاند.
- جهت پاراگرافها را ببینید. اگر چپچین است، پاراگراف را انتخاب کنید و جهت را راستبهچپ کنید (Ctrl و Shift سمت راست).
- قلم را یکدست کنید. قلم جایگزین شاید حروف را درست نشان دهد ولی ظاهر سند را عوض کند.
اگر فقط ترتیب پاراگراف و قلم مشکل دارد، چند دقیقه کار اصلاحش میکند. اگر داخل کلمهها حروف برعکساند، اصلاح دستی تقریباً همان تایپ دوباره است؛ آن وقت فایل اصلی ورد را از فرستنده بخواهید.
مراقب مبدلهایی باشید که صفحهآرایی را مو به مو بازتولید میکنند
برخی ابزارها تبلیغ میکنند که خروجی پیکسلبهپیکسل با نسخه اصلی یکی است. بازش میکنید و واقعاً هم همینطور است. بعد یک سطر را ویرایش میکنید و سند فرو میریزد.
رسیدن به آن یعنی ریختن متن در صدها کادر متنی میخشده روی مختصات ثابت، به جای گذاشتنش در بندها. سندی که اینطور ساخته شود شبیه نسخه اصلی است اما نمیشود در آن کار کرد. یک نویسه را پاک کنید، تنها همان کادر جابهجا میشود و بقیه سر جایشان میمانند.
| چه میخواهید | چه انتخاب کنید |
|---|---|
| خواندن و ویرایش محتوا | مبدلی که بندها را بازسازی میکند |
| فقط خواندن | تبدیل نکنید، از نمایشگر PDF استفاده کنید |
| باید عین نسخه چاپی باشد | تبدیل نکنید، همان PDF را نگه دارید |
| محاسبه روی اعداد | به کاربرگ تبدیل کنید |
تبدیل برای آن است که بتوانید ویرایش کنید. خروجیای که نمیتوانید ویرایش کنید هدفش را از دست داده است. اگر هدف شبیه بودن است، از همان اول دلیلی برای تبدیل نبوده.
دلیل واقعی نادرست درآمدن جدولها
جدولهای درون PDF بسیار اوقات هیچ خطی ندارند. آنجا هم که دارند، آن خطها روی لایهای جدا از متن کشیده شدهاند و برای هر چیزی که واژهها را بیرون میکشد نامرئیاند. به همین دلیل است که روشهای مبتنی بر یافتن خط اینقدر مکرر شکست میخورند.
پس آنچه خوانده میشود موقعیت است: خانههایی که لبهشان در چند سطر در یک جا میایستد جدول شمرده میشوند. این روش در خانههای خالی از همه ضعیفتر است. خانه خالی هیچ ردی در فایل نمیگذارد، پس آن ردیف یک خانه کم به نظر میرسد و هرچه پس از آن است یک خانه جابهجا میشود.
خانههای ادغامشده هم همینطورند. چشم شما دو خانه بههمچسبیده میبیند؛ فایل یک تکه متن دارد که کمی چپتر از همسایههایش نشسته است.
اگر فقط جدول را لازم دارید و جدول فارسی است، نوشتهٔ تبدیل جدول PDF فارسی به اکسل را ببینید؛ آنجا گفتهایم ستونهای برعکس و رقمهای فارسی را چطور درست کنید.
هیچ ابزاری PDF اسکنشده را تبدیل نمیکند
PDFای که اسکنر اداری تولید کرده برای هر صفحه یک عکس است. چشم شما حرف میبیند، فایل حتی یک حرف ندارد. این محدودیت ابزار نیست، نبودِ داده در منبع است.
بازشناسی نوری نویسه میتواند از روی تصویر متن بسازد. اما آن بازشناسی است نه بیرون کشیدن، و خطاهایی مثل خواندن صفر به جای حرف O را قاطی میکند. در یک قرارداد یا فرمی که تحویل میدهید، چنین خطایی گران تمام میشود. درخواست فایل اصلی از صادرکننده معمولاً سریعتر است.
PDF اسکنشدهٔ فارسی: OCR لازم است
برای PDF اسکنشده، تبدیل به ورد بدون OCR (بازشناسی نوری نویسه) فقط عکس صفحهها را در ورد میگذارد. ابزار PDF به Word ما OCR ندارد و برای صفحهٔ بدون متن میگوید که نمیتواند از تصویر متن بخواند. OCR فارسی کار جداگانهای است و ابزاری لازم دارد که صراحتاً فارسی را پشتیبانی کند.
- پیش از OCR، اسکن را صاف و راست کنید؛ صفحهٔ کج یا وارونه نتیجه را خیلی بدتر میکند.
- وضوح اسکن را حدود ۳۰۰ DPI بگیرید. اسکن کموضوح نقطهها و سرکش حروف فارسی را گم میکند.
- خروجی OCR فارسی را حتماً بخوانید: «ب، پ، ت، ث» و «ج، چ، ح، خ» که فقط در نقطه فرق دارند، رایجترین خطاها هستند.
خلاصه
پرسشی که باید از یک مبدل کرد این نیست که چقدر شبیه است، بلکه این است که آیا میتوانید آنچه بیرون میآید را ویرایش کنید. و وقتی نتیجه کامل نیست، توانایی تشخیص مرز ابزار از مرز قالب شما را از عوض کردن بیهوده ابزارها نجات میدهد.
اگر تنها کاری که میخواهید عوض کردن یکی دو رقم یا گذاشتن امضا روی همان PDF است، اصلاً تبدیل نکنید؛ ویرایشگر PDF ما این کارها را روی خود فایل انجام میدهد. متن فارسی را آن هم هنوز ویرایش نمیکند، ولی عدد لاتین، امضا، تصویر و هایلایت مشکلی ندارند.
پرسشهای پرتکرار
- چرا متن فارسی بعد از تبدیل برعکس میشود؟
- چون PDF حروف را به ترتیب کشیدهشدن ذخیره میکند، نه به ترتیب خواندن، و مبدل باید ترتیب راستبهچپ را حدس بزند. هر جا این حدس خطا کند، بهویژه کنار عدد و کلمهٔ انگلیسی، کلمهها برعکس یا جابهجا میشوند.
- ی و ک عربی را چطور درست کنم؟
- در ورد Ctrl+H را بزنید، ي عربی را با ی فارسی و ك عربی را با ک فارسی جایگزین کنید و «Replace All» را بزنید. بعد یک جستوجوی آزمایشی بگیرید.
- مبدل رایگانی که فارسی را درست تبدیل کند هست؟
- صادقانه: ابزار ما برای فارسی هنوز مناسب نیست، و ابزارهای دیگر را خودمان با PDF فارسی نیازمودهایم. هر مبدلی را امتحان میکنید، با یک صفحه شروع کنید و ترتیب کلمهها و جستوجو را چک کنید. مطمئنترین راه هنوز گرفتن فایل اصلی ورد از فرستنده است.
- جدولهایم مدام نادرست درمیآیند. کاری میشود کرد؟
- هرچه جدول خانه خالی بیشتری داشته باشد نتیجه بدتر است، چون خانه خالی در PDF ردی نمیگذارد. اگر فقط جدول را میخواهید، تبدیل به کاربرگ بهتر از تبدیل به Word است. آن مسیر عمداً خانهها را در ستونها میاندازد و جابهجایی را با دست آسانتر میشود درست کرد.
- آیا تصویرها و مهرها منتقل میشوند؟
- بله. آنها اشیای واقعی چاپشده روی صفحهاند، پس حدسی لازم نیست و همانطور که هستند بیرون کشیده میشوند. اینکه کجا مینشینند را ترتیب خواندن تعیین میکند نه مختصات اصلی، چون میخ کردنشان روی مختصات سندی میدهد که نمیتوانید ویرایشش کنید.
- آیا مبدلی هست که فایل مرا بارگذاری نکند؟
- بله، ابزارهای همین سایت اینطور کار میکنند. کل تبدیل درون مرورگر تمام میشود و فایل جایی فرستاده نمیشود. برای بررسی، زبانهٔ Network را در ابزار توسعهدهنده باز کنید و یک تبدیل را اجرا کنید. فقط یادتان باشد PDF به Word ما متن فارسی را هنوز درست تبدیل نمیکند.
بهروزرسانی ۲۲ مهر ۱۴۰۵ · اطلاعات این نوشته مربوط به مهر ۱۴۰۵ (اکتبر ۲۰۲۶) است.