
Chuyển PDF sang Word: vì sao lỗi font và cái gì bị mất
Bạn chuyển một tệp PDF sang Word và cái bảng méo xẹo. Bạn cho rằng công cụ dở, thử cái khác, và kết quả cũng gần như vậy. Có những vấn đề không biến mất khi đổi công cụ.

Hiểu vì sao sẽ cho bạn biết nên chọn công cụ nào và trông đợi đến đâu.
PDF là bản in chứ không phải tài liệu
Thứ nằm trong một tệp PDF là danh sách dài các lệnh bảo in ký tự này ở toạ độ 72, 680. Không nơi nào trong tệp ghi lại đoạn văn kết thúc ở đâu, hay hai dòng nào từng thuộc cùng một hàng của một cái bảng.
Thông tin ấy bị vứt đi ngay khi tài liệu được xuất ra PDF, đúng như một tờ giấy in ra thì chẳng cần đến nó. Vậy nên đưa nó trở lại là dựng lại chứ không phải chuyển đổi: hình dạng ban đầu được suy ra từ chỗ các ký tự ngồi.
Chỉ một câu đó giải thích mọi thứ còn lại. Cái bảng méo không phải vì công cụ đọc sai bảng, mà vì chẳng có bảng nào để đọc và nó phải được suy ra chỉ từ vị trí.
Cái suy ra được và cái chưa từng có
Tách hai loại này ra là biết cái gì có thể cải thiện và cái gì thì không.
- Suy ra được. Ngắt đoạn, từ khoảng cách dòng và chỗ dòng dừng lại. Bảng, từ việc các ô có thẳng hàng xuống dưới hay không. Tiêu đề, từ cỡ chữ lớn hơn thân bài. Thuật toán tốt hơn thì chính xác hơn.
- Rút ra trực tiếp được. Bản thân các ký tự, cùng mọi hình ảnh hay con dấu in trên trang. Chúng là những đối tượng có thật trong tệp, không cần đoán.
- Chưa từng được ghi. Bản gốc dùng kiểu Word nào, bảng gộp ô ở đâu, giữa các đoạn cách nhau bao nhiêu điểm. Không công cụ nào tạo ra được những thứ này.
Lỗi font tiếng Việt khi chuyển
Đây là câu người Việt hỏi nhiều nhất: chuyển xong thì chữ có dấu thành ký tự lạ, dấu rơi ra khỏi chữ, hoặc chữ “ư”, “ơ” biến mất. Trên Voz có người kể đã thử cả ABBYY, một phần mềm trả phí có tiếng, mà chữ tiếng Việt vẫn vỡ. Đổi công cụ không hết vì nguyên nhân nằm trong chính tệp PDF, thường là một trong ba trường hợp sau.
- PDF tạo từ bảng mã cũ TCVN3 (ABC) hoặc VNI. Trước khi Unicode phổ biến, nhiều cơ quan và công ty soạn văn bản bằng phông .VnTime hay VNI-Times. Mỗi chữ có dấu được lưu bằng một mã riêng của bảng mã đó chứ không phải mã Unicode. Trên màn hình vẫn hiện đúng nhờ phông nhúng, nhưng khi rút chữ ra, công cụ nào cũng nhận được những mã cũ ấy và hiện thành chuỗi ký tự Latin vô nghĩa.
- Phông nhúng không có bảng ánh xạ ký tự. PDF chỉ cần biết vẽ hình nào ở đâu, nên có tệp không ghi “hình này là chữ ế”. Thiếu bảng đó, công cụ chuyển đổi chỉ đoán được, và chữ có dấu là chỗ đoán sai nhiều nhất.
- Chữ có dấu được vẽ bằng chữ gốc cộng dấu rời. Khi dựng lại, dấu có thể đứng tách ra hoặc bám nhầm chữ bên cạnh.
Cách thử trong 10 giây: mở PDF, bôi đen một từ có dấu, dán vào Notepad hoặc ô tìm kiếm. Dán ra đúng chữ thì chuyển sang Word sẽ ra đúng chữ. Dán ra ký tự lạ thì tệp thuộc một trong ba trường hợp trên, và cách nhanh nhất là xin bên phát hành bản Word gốc. Với TCVN3 hay VNI, một số bộ gõ tiếng Việt có chức năng chuyển mã sang Unicode sau khi đã dán chữ ra, nhưng hãy soát lại kết quả.
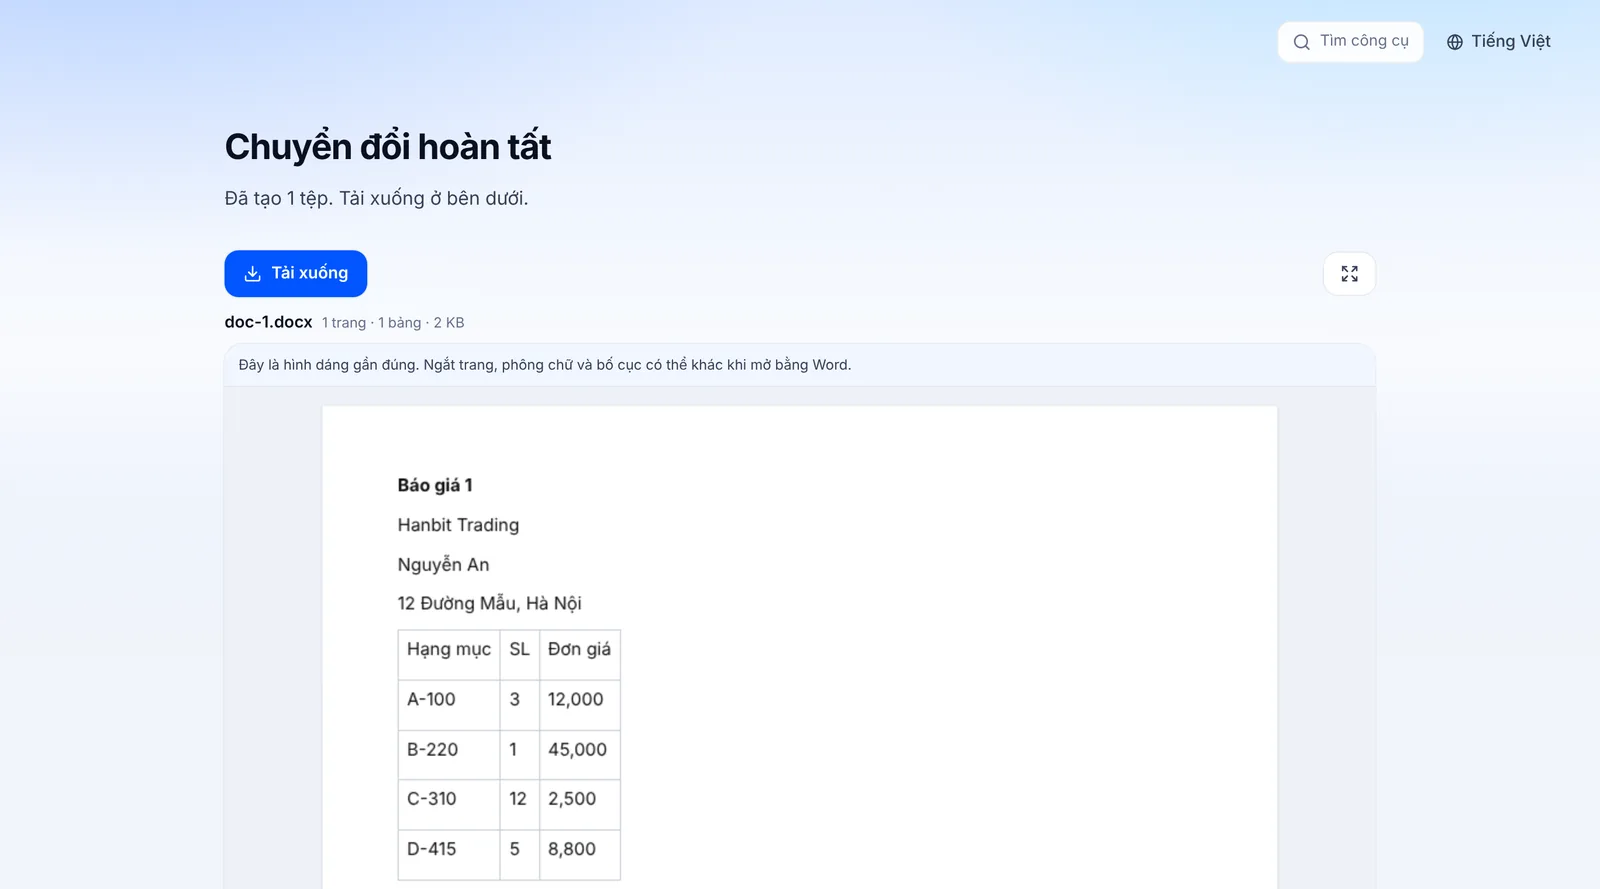
Với PDF có chữ Unicode bình thường, chúng tôi đã thử công cụ PDF sang Word của EZPZ File với văn bản tiếng Việt và chữ có dấu sang đúng. Phông chữ thì không được mang theo, như phần trên giải thích, nên tài liệu mở ra bằng phông mặc định của Word.
Hãy dè chừng công cụ tái hiện bố cục y hệt
Một số công cụ quảng cáo kết quả khớp bản gốc tới từng điểm ảnh. Mở ra thì đúng là thế thật. Rồi bạn sửa một dòng và tài liệu sụp đổ.
Làm được vậy nghĩa là nhét chữ vào hàng trăm hộp văn bản ghim ở toạ độ cố định thay vì vào các đoạn văn. Một tài liệu dựng kiểu đó trông giống bản gốc nhưng không làm việc được. Xoá một ký tự thì chỉ mỗi hộp đó co lại, mọi thứ quanh nó đứng yên.
| Bạn cần gì | Chọn gì |
|---|---|
| Đọc và sửa nội dung | Công cụ dựng lại đoạn văn |
| Chỉ để đọc | Đừng chuyển đổi, dùng trình đọc PDF |
| Phải khớp bản in y hệt | Đừng chuyển đổi, giữ nguyên PDF |
| Tính toán với các con số | Chuyển sang bảng tính |
Chuyển đổi tồn tại để bạn sửa được. Kết quả không sửa được thì đã mất đi lý do của nó. Nếu mục tiêu là trông y hệt, ngay từ đầu đã chẳng có lý do gì để chuyển đổi.
Lý do thật sự khiến bảng bị sai
Bảng trong PDF rất thường không hề có đường kẻ. Chỗ nào có thì những đường ấy được vẽ ở lớp khác với chữ, vô hình với mọi thứ đang rút chữ ra. Đó là lý do các cách làm dựa trên tìm đường kẻ hỏng thường xuyên đến vậy.
Nên thứ được đọc là vị trí: các ô có mép trái đứng cùng chỗ qua vài dòng được coi là một cái bảng. Cách này yếu nhất ở ô rỗng. Một ô rỗng không để lại dấu vết nào trong tệp, nên hàng đó đơn giản là trông như thiếu một ô và mọi thứ sau nó lệch đi một.
Ô gộp cũng vậy. Mắt bạn thấy hai ô nhập làm một; trong tệp chỉ có một đoạn chữ ngồi lệch sang trái hơn hàng xóm một chút.
Không công cụ nào chuyển được PDF quét
Một tệp PDF do máy quét văn phòng tạo ra là một tấm ảnh cho mỗi trang. Mắt bạn thấy chữ, tệp thì không chứa chữ nào. Đây không phải giới hạn của công cụ mà là sự thiếu vắng ở bản gốc.
Nhận dạng ký tự quang học có thể chế ra chữ từ bức ảnh. Nhưng đó là nhận dạng chứ không phải trích xuất, và nó lẫn vào những lỗi như đọc số không thành chữ O. Trong một hợp đồng hay một hồ sơ nộp đi, loại lỗi ấy rất đắt. Xin bên phát hành tệp gốc thường nhanh hơn.
File scan sang Word
“Chuyển file scan sang Word” là nhu cầu rất lớn, vì giấy tờ hành chính ở Việt Nam hay được scan rồi gửi đi. Nhưng như phần trên nói, bản scan không có chữ, chỉ có ảnh. Muốn có chữ phải nhận dạng ký tự quang học (OCR), và với tiếng Việt, OCR hay sai đúng ở chỗ khó nhất: dấu thanh. “Hỏi” thành “hói”, “ngã” thành “ngà”, chữ “đ” thành “d”.
- Công cụ PDF sang Word của chúng tôi không có OCR. Thả bản scan vào, nó báo thẳng những trang không có chữ thay vì đưa ra tệp rỗng.
- Nếu dùng phần mềm có OCR, chọn đúng ngôn ngữ nhận dạng là tiếng Việt và soát lại từng dòng có số, tên người, ngày tháng.
- Nếu chỉ cần sửa vài chỗ trên bản scan, đừng chuyển sang Word: che rồi gõ chữ mới ngay trên PDF.
Cách che rồi gõ lại, kể cả với chữ tiếng Việt, nằm trong bài cách sửa chữ trong file PDF.
Với tài liệu nhiều bảng như bảng lương hay sao kê, chuyển sang Excel thường tốt hơn chuyển sang Word, xem bài chuyển bảng PDF sang Excel không lỗi font.
Tóm lại
Câu hỏi dành cho một công cụ chuyển đổi không phải nó khớp đến đâu, mà là bạn có sửa được thứ nó tạo ra không. Và khi kết quả chưa hoàn hảo, phân biệt được đâu là giới hạn của công cụ và đâu là giới hạn của định dạng sẽ giúp bạn khỏi đổi công cụ vô ích.
Câu hỏi thường gặp
- Vì sao chuyển sang Word bị lỗi font?
- Thường do PDF được tạo bằng bảng mã cũ TCVN3, VNI, hoặc phông nhúng không ghi hình nào là chữ nào. Bôi đen một từ có dấu trong PDF rồi dán ra Notepad: nếu ra ký tự lạ thì đổi công cụ cũng khó cứu.
- PDF scan sang Word được không?
- Chỉ bằng phần mềm có OCR, và với tiếng Việt phải soát lại dấu. Công cụ của trang này không có OCR và sẽ báo những trang scan không có chữ.
- File có dấu bị mất dấu?
- Nếu PDF có chữ Unicode, dấu thường sang đúng; chúng tôi đã thử với tiếng Việt. Mất dấu hay gặp ở PDF dùng TCVN3, VNI, ở bản scan qua OCR, hoặc khi dấu được vẽ rời khỏi chữ gốc.
- Vì sao các công cụ khác nhau cho kết quả khác nhau?
- Vì quy tắc suy luận của chúng khác nhau. Khoảng hở rộng bao nhiêu thì tính là ngắt đoạn, bao nhiêu hàng thẳng hàng thì tính là bảng: mỗi công cụ vạch những ranh giới ấy ở chỗ hơi khác nhau. Vì vậy công cụ này hợp với loại tài liệu này hơn công cụ kia.
- Bảng của tôi cứ sai mãi. Có cách nào không?
- Bảng càng nhiều ô rỗng thì càng tệ, vì ô rỗng không để lại dấu vết trong PDF. Nếu bạn chỉ cần cái bảng, chuyển sang bảng tính tốt hơn chuyển sang Word. Đường bảng tính cố ý dồn ô vào cột, và lệch thì cũng dễ sửa tay hơn.
- Có công cụ nào không tải tệp của tôi lên không?
- Có, các công cụ trên trang này làm vậy. Toàn bộ việc chuyển đổi kết thúc bên trong trình duyệt nên không có bước tải lên. Để kiểm tra, hãy mở tab mạng trong công cụ dành cho nhà phát triển rồi chạy một lần chuyển đổi.
Cập nhật 14 tháng 10, 2026 · Thông tin tính đến tháng 10 năm 2026.


