
PDF 워드 변환, 남는 것과 사라지는 것
PDF 워드 변환을 했더니 표가 어긋나 있다. 변환기가 나쁜 건가 싶어 무료 PDF 워드 변환 사이트를 몇 군데 더 써 봐도 비슷하다. 도구를 바꿔도 해결되지 않는 종류의 문제가 있다.

이유를 알면 어떤 도구를 고를지, 어디까지 기대할지가 정해진다.
PDF에는 인쇄된 모습만 담긴다
PDF 안에 들어 있는 것은 "가로 72, 세로 680 자리에 이 글자를 찍어라" 같은 지시의 긴 목록이다. 어디서 문단이 끊겼는지, 어느 줄과 어느 줄이 한 표의 같은 행이었는지는 파일 어디에도 적혀 있지 않다.
워드에서 PDF로 내보내는 순간 그 정보가 버려지기 때문이다. 종이에 인쇄할 때 문단 정보가 필요 없는 것과 같다. 그래서 되돌릴 때는 글자가 놓인 자리를 보고 원래 모양을 추측해 복원한다.
이 점 하나가 나머지를 다 설명한다. 표가 어긋나는 것은 읽을 표가 애초에 없어서 자리만 보고 표를 짐작해 다시 만들기 때문이다.
추측할 수 있는 것과 아예 없는 정보
이 둘을 구분하면 무엇이 개선 가능하고 무엇이 불가능한지가 보인다.
- 추측할 수 있는 것. 문단 구분(줄 간격과 줄 끝 위치로), 표(칸이 여러 줄에 걸쳐 줄 맞춰 섰는지로), 제목(본문보다 큰 글씨인지로). 알고리즘이 좋아지면 정확도가 올라간다.
- 그대로 꺼낼 수 있는 것. 글자, 그리고 쪽에 박혀 있는 그림과 도장. 이것들은 실물이라 추측이 필요 없다.
- 아예 없는 정보. 원본이 어떤 워드 스타일을 썼는지, 표의 셀이 어디서 합쳐졌는지, 문단 사이 여백이 몇 포인트였는지. 어떤 도구도 이건 못 만들어 낸다.
배치를 똑같이 만드는 변환기를 조심하라
변환 결과가 원본과 픽셀 단위로 똑같다고 광고하는 도구가 있다. 실제로 열어 보면 정말 똑같다. 그런데 한 줄을 고치는 순간 문서가 무너진다.
그렇게 만들려면 글자를 문단이 아니라 글상자에 담아 좌표에 박아야 하기 때문이다. 글상자 수백 개가 각자 제자리에 떠 있는 문서는 보기에는 원본이지만 편집할 수는 없다. 글자 하나를 지우면 그 상자만 줄고 나머지는 그대로 있다.
| 무엇을 원하나 | 고를 것 |
|---|---|
| 내용을 읽고 고쳐야 한다 | 문단으로 되살리는 도구 |
| 보기만 하면 된다 | 변환하지 말고 PDF 뷰어로 보기 |
| 인쇄본과 똑같아야 한다 | 변환하지 말고 PDF 그대로 쓰기 |
| 표의 숫자를 계산해야 한다 | 엑셀로 변환 |
변환은 고치기 위해 하는 일이다. 고칠 수 없는 결과물은 제 구실을 못 한다. 원본과 똑같아 보이는 것이 목적이라면 애초에 변환할 이유가 없다.
표가 어긋나는 진짜 이유
PDF의 표에는 선이 없는 경우가 아주 흔하다. 있더라도 그 선은 글자와 다른 층에 그려져 있어서 글을 꺼내는 쪽에서는 보이지 않는다. 선을 찾아 표를 알아내려는 방법이 자주 실패하는 이유다.
그래서 자리를 본다. 칸의 왼쪽 끝이 여러 줄에 걸쳐 같은 자리에 서 있으면 표로 본다. 이 방법은 값이 빈 칸에서 약해진다. 빈 칸은 PDF 안에 아무 흔적도 남기지 않으므로, 그 줄만 칸이 하나 적어 보이고 결과가 한 칸씩 밀린다.
합쳐진 셀도 마찬가지다. 사람 눈에는 두 칸이 합쳐진 것이 보이지만 파일 안에는 그냥 글자 하나가 조금 왼쪽에 있을 뿐이다.
표의 숫자만 필요하다면 워드보다 엑셀이 맞다. PDF 표를 엑셀로 옮기는 요령도 따로 적었다.
스캔한 PDF는 어떤 도구로도 안 된다
복합기로 스캔해 만든 PDF는 쪽 전체가 사진 한 장이다. 사람 눈에는 글자로 보이지만 파일 안에는 글자가 한 자도 없다. 원본에 없는 정보는 어떤 도구로도 꺼낼 수 없다.
글자 인식(OCR)을 쓰면 만들어 낼 수는 있다. 다만 모양을 보고 짐작하는 방식이라 숫자 0과 영문 O를 뒤바꾸는 식의 오류가 섞인다. 계약서나 제출 서류에서는 그런 오류가 큰 문제가 된다. 가능하면 발급처에 원본 파일을 요청하는 편이 빠르다.
도장 찍힌 증명서를 워드로 바꿨더니 도장이 깨질 때
지식iN에는 스캔한 재직증명서를 워드로 바꿨더니 대표 도장이 계속 깨진다는 질문이 올라온다. 이런 경우는 대개 두 가지가 겹친 것이다. 스캔본이라 쪽 전체가 사진 한 장이고, 도장도 그 사진의 일부라 따로 떼어 낼 수 있는 실물이 아니다.
글자로 된 PDF라면 도장은 쪽에 박힌 그림이라 그대로 넘어온다. 스캔본은 글자도 도장도 한 장의 사진이어서, 글자 인식을 거치는 변환기는 도장 부분을 글자로 읽으려다 뭉개거나 조각낸다.
증명서를 워드로 바꾸는 이유가 내용을 고쳐 쓰기 위해서라면 멈추는 편이 좋다. 발급받은 증명서의 내용을 바꾸거나 도장을 다른 문서에 옮겨 붙이면 위조 문제가 될 수 있다. 내용이 달라져야 한다면 발급처에 다시 발급을 요청한다.
보관이나 제출만 하면 되는 증명서라면 변환하지 않고 PDF 그대로 쓰는 것이 가장 안전하다.
한글 문서로 내야 한다면
받은 PDF를 결국 한글로 고쳐서 내야 하는 경우가 많다. 그렇다면 워드를 거치지 말고 바로 HWP로 바꾸는 편이 낫다. 워드를 한 번 거치면 변환이 두 번이 되고, 그때마다 표와 문단이 조금씩 더 틀어진다.
한컴오피스 없이 PDF를 한글 문서로 바꾸는 순서는 따로 정리해 두었다.
PDF 워드 변환, 이 사이트에서 하면
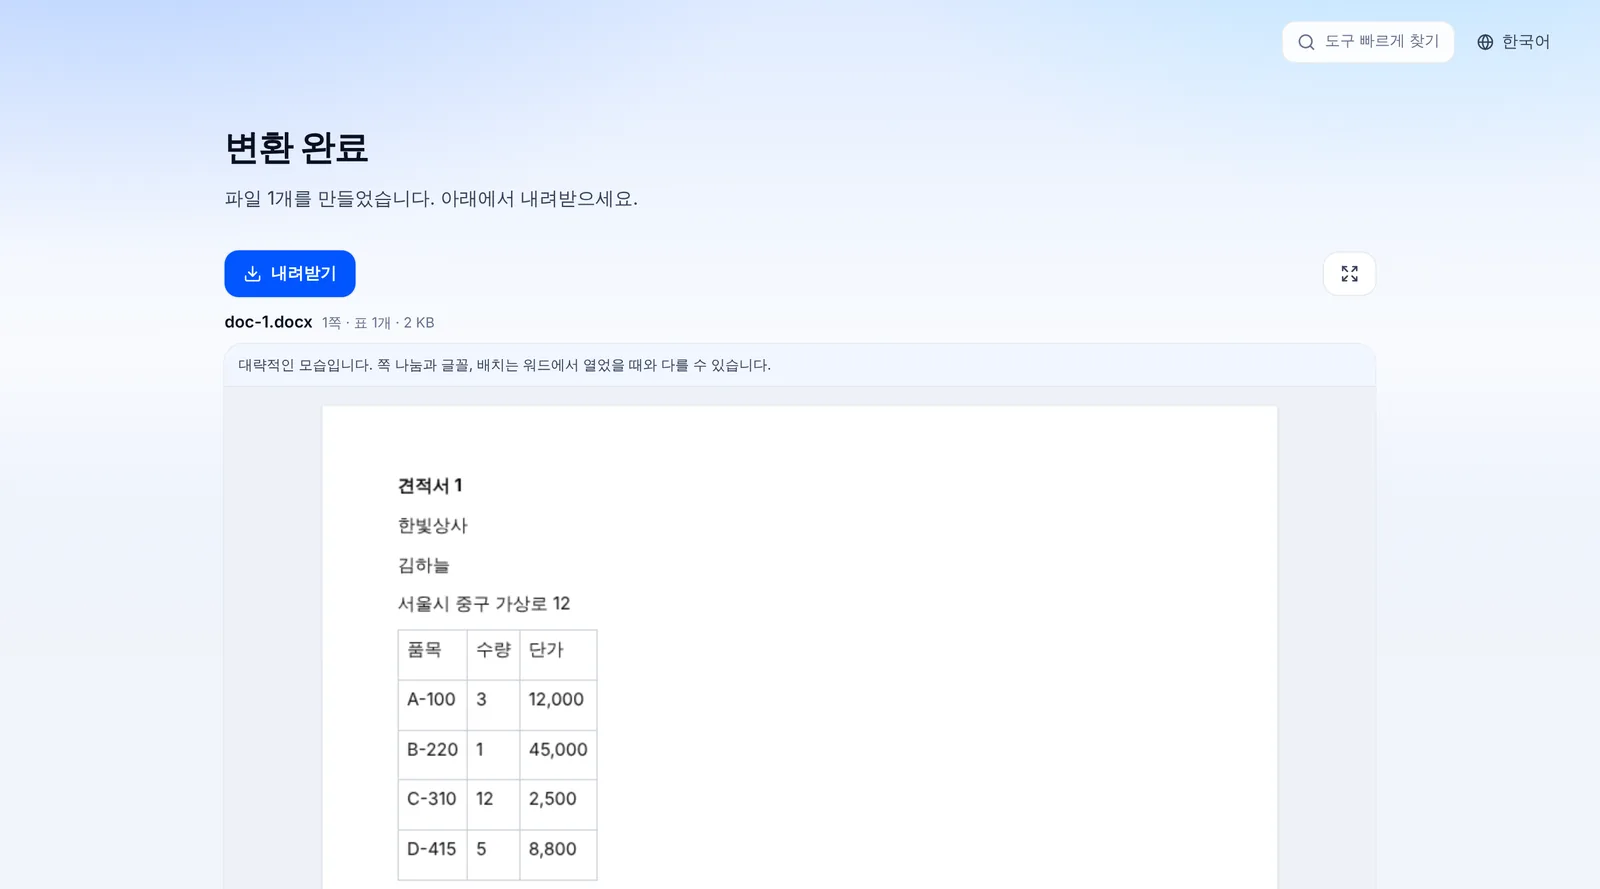
이 사이트의 PDF 워드 변환은 글을 문단과 표로 되살려 DOCX로 만든다. 글상자로 좌표에 박지 않으므로 워드에서 바로 고칠 수 있다. 쪽에 박힌 그림과 도장, 서명도 꺼내어 넣는다. 변환은 브라우저 안에서 끝나서 파일이 내 PC를 떠나지 않고, 가입도 없다.
스캔한 PDF는 글자 인식을 하지 않는다. 넣으면 글자가 없다고 바로 알려 주고, 일부 쪽만 스캔이면 몇 쪽이 비었는지 번호로 말해 준다.
반대로 받은 워드 파일에서 글자만 꺼내고 싶다면 DOCX 텍스트 추출을 쓰면 된다.
정리하면
변환기를 고를 때는 "얼마나 똑같은가" 보다 "고칠 수 있는가" 를 먼저 묻는다. 그리고 결과가 완벽하지 않을 때, 그것이 도구의 한계인지 형식의 한계인지 구분할 수 있으면 헛되이 도구를 갈아 끼우는 시간을 아낄 수 있다.
자주 묻는 것
- pdf 워드 변환하면 표가 깨져요
- 값이 빈 칸이 많은 표일수록 어긋납니다. 빈 칸이 PDF 안에 흔적을 남기지 않아서 그 줄만 칸이 하나 적어 보이기 때문입니다. 표만 필요하다면 워드보다 엑셀로 바꾸는 편이 낫습니다. 엑셀 쪽은 칸을 열에 맞춰 넣는 처리를 따로 하고, 어긋나도 손으로 고치기 쉽습니다.
- pdf를 한글로 바꾸는 게 나을까요?
- 최종 문서를 한글로 내야 한다면 그렇습니다. PDF를 워드로 바꾼 뒤 다시 한글로 옮기면 변환이 두 번이 되어 표와 문단이 더 틀어집니다. 처음부터 PDF를 HWP로 바꾸는 편이 덜 깨집니다.
- 무료 pdf 워드 변환 어디까지 되나요?
- 글자로 된 PDF라면 글의 순서, 문단, 제목, 표, 그림과 도장까지는 무료 도구로도 넘어옵니다. 원래 배치와 글꼴, 글자 색은 어떤 도구로도 완전히 되살리기 어렵습니다. 스캔한 PDF는 글자 인식이 필요한데, 이 사이트의 변환기는 글자 인식을 하지 않습니다.
- 변환기마다 결과가 다른 이유는 뭔가요?
- 추측하는 규칙이 다르기 때문입니다. 줄 간격이 얼마나 벌어져야 문단이 끊긴 것으로 볼지, 칸이 몇 줄 이상 줄 맞춰 서야 표로 볼지 같은 기준을 저마다 다르게 잡습니다. 그래서 문서 종류에 따라 잘 맞는 도구가 갈립니다.
- 그림과 도장도 넘어오나요?
- 넘어옵니다. 쪽에 박혀 있는 실물이라 추측 없이 그대로 꺼냅니다. 다만 놓이는 자리는 원래 좌표가 아니라 글의 순서를 따릅니다. 좌표에 박으면 고칠 수 없는 문서가 되기 때문입니다.
- 파일을 서버로 보내지 않는 변환기가 있나요?
- 있습니다. 이 사이트의 도구가 그렇습니다. 변환이 전부 브라우저 안에서 끝나므로 파일이 서버로 가는 단계가 없습니다. 확인하려면 개발자 도구의 네트워크 탭을 열어 두고 변환을 눌러 보면 됩니다.
최종 수정 2026년 10월 14일 · 2026년 10월 기준.


